Em 23 de setembro de 2026, a reportagem de O Globo relatou que alguns gabinetes do STF dedicaram equipes, ainda que reduzidas, para analisar o conteúdo de um celular apreendido: cerca de 510 GB em 32,7 mil arquivos, entre chats, áudios e registros de chamadas. O desafio, segundo interlocutores ouvidos pelo jornal, é a falta de gente para ler e ouvir tudo sem parar o resto do trabalho.
Uma equipe de 4 pessoas em tempo parcial levaria de 3 a 9 meses (cerca de 5, nas premissas deste exercício) para ler as mensagens e ouvir os áudios. Uma arquitetura no Databricks, com os modelos rodando no Brasil, reduz isso a dias de processamento automatizado e algumas semanas de revisão humana, com custo de processamento estimado em US$ 675 a 875, mais cerca de US$ 5 mil por mês para manter a plataforma no ar durante a revisão.
Quanto tempo levaria a leitura manual?
Vamos parar para pensar e estimar quanto tempo uma equipe de aproximadamente 4 pessoas, trabalhando em tempo parcial, levaria para analisar esse conjunto de dados. Suponha que o volume da reportagem corresponda a cerca de 500 mil mensagens e 500 horas de áudio, com documentos e imagens fechando a conta dos 510 GB.
Levando em consideração algumas premissas:
- Capacidade da equipe: 4 pessoas vezes 4 h/dia = 16 h/dia, com cerca de 21,75 dias úteis por mês.
- Leitura de cerca de 500 mensagens por hora, com atenção e algumas anotações.
- Cada hora de áudio toma cerca de 1,5 hora de análise, contando pausas, trechos ouvidos de novo e anotações.
- A conta cobre mensagens e áudios. Imagens e documentos, que respondem pela maior parte dos 510 GB em bytes, ficam de fora, o que torna a estimativa conservadora.
Com essas premissas, seriam cerca de 1.750 horas de trabalho, ou cerca de 5 meses (a equipe soma 348 h por mês). O prazo muda bastante com o ritmo de leitura. Numa leitura de triagem, com 1.000 mensagens por hora e cada hora de áudio tomando 1,2 hora de análise, seriam cerca de 1.100 horas, ou 3 meses. Em uma análise cuidadosa, lendo 250 mensagens por hora, com cada hora de áudio tomando 2 horas de análise, seriam cerca de 3.000 horas, ou cerca de 9 meses.
Quem trabalha com arquitetura de dados sabe que analisar 510 GB de informação não chega a ser um caso tão complexo assim. A complexidade está no contexto jurídico, em que confidencialidade e controle sobre os dados são críticos, e no ganho de tempo que uma solução automatizada pode trazer.
Este artigo trata a reportagem como uma fonte de requisitos para um problema de arquitetura de dados e propõe uma arquitetura no Databricks para esse tipo de análise. O objetivo não é opinar sobre o caso nem sobre o conteúdo do aparelho. É mostrar como ingestão, transcrição, LLMs e governança podem transformar meses de leitura em dias de processamento automatizado, seguidos da revisão humana do que for sinalizado, e discutir os limites da solução do ponto de vista técnico, jurídico e ético.
Requisitos extraídos da reportagem
Antes de mais nada, precisamos entender o que de fato precisa ser feito e listar os requisitos da solução, funcionais e não funcionais.
| ID | Requisito | Evidência na reportagem |
|---|---|---|
| RF01 | Ingerir cerca de 510 GB e 32,7 mil arquivos heterogêneos | Chats, áudios e registros de chamadas |
| RF02 | Transcrever áudios em português, com falante e horário | Áudios entre os arquivos |
| RF03 | Localizar menções a pessoas e autoridades nos diálogos | Equipes buscam "as referências nos diálogos" |
| RF04 | Restringir a análise ao objeto autorizado | Cautela para usar o material só no que foi solicitado |
| RF05 | Confrontar um relatório existente com as mensagens que o sustentam ou contradizem | A reportagem menciona a análise de um relatório oficial sobre as mensagens |
| RF06 | Gerar relatórios que citam diálogos com referência verificável | Relatórios periciais que citam diálogos, mencionados pela reportagem |
| RF07 | Montar linha do tempo e rede de contatos | Registros de chamadas e conversas com vários contatos |
| RNF01 | Acesso restrito, por menor privilégio | Primeira medida foi "restringir o acesso ao material" |
| RNF02 | Conteúdo íntimo oculto por padrão | Grande volume de informações pessoais e de intimidade |
| RNF03 | Isolamento entre gabinetes | Cinco gabinetes, cada um com método próprio |
| RNF04 | Produtividade com equipes pequenas | "Falta de braço" nos times, segundo interlocutores ouvidos pela reportagem |
| RNF05 | Auditoria completa e rastreabilidade | Material é prova judicial |
| RNF06 | Escalar para volumes de vários TB | Um caso anterior citado pela reportagem tinha cerca de 7 TB |
| RNF07 | Processamento dentro do país | Requisito assumido pelo exercício: material sob sigilo; decorre de RNF01 e RNF05 |
Arquitetura proposta no Databricks
Com base nos requisitos, montamos uma arquitetura de referência que usa os conceitos de arquitetura medalhão (camadas que refinam o dado a cada etapa) e lakehouse.
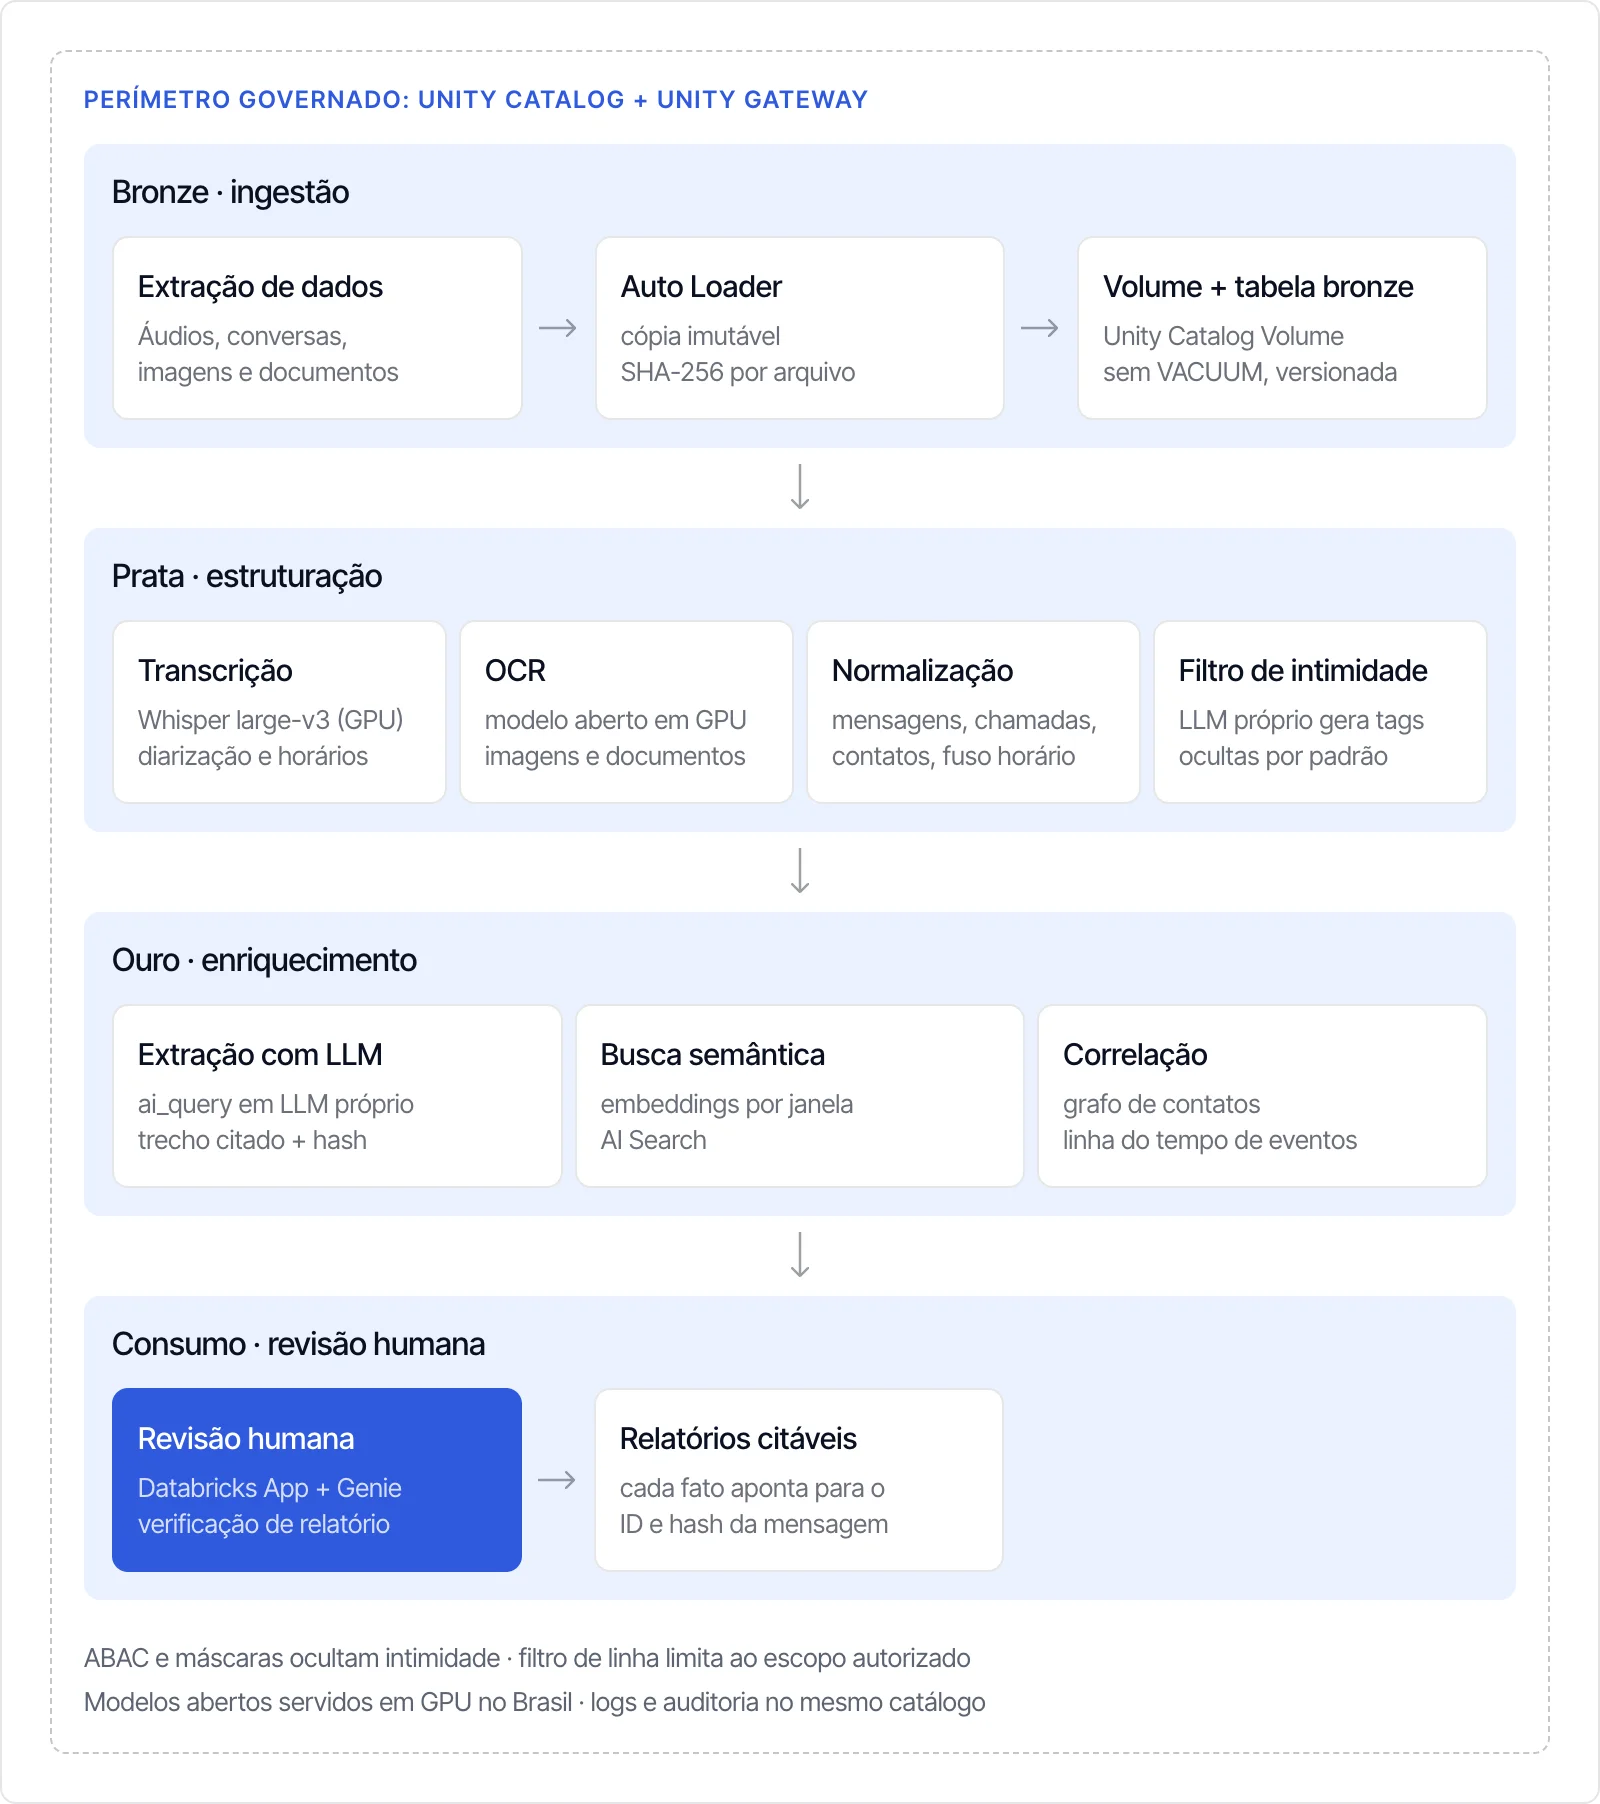
Em resumo, a arquitetura organiza o material em quatro camadas, dentro de um mesmo perímetro governado pelo Unity Catalog. Na bronze, os arquivos extraídos do aparelho são copiados sem alteração, cada um com seu hash SHA-256. Na prata, os áudios são transcritos, chats e chamadas viram tabelas normalizadas com um hash por mensagem, documentos passam por OCR, e o possível conteúdo íntimo é marcado e escondido por padrão. Na ouro, um modelo aberto servido no Brasil extrai pessoas, eventos, valores e datas, sempre com o trecho literal e a referência da mensagem de origem, e monta o grafo de contatos e a linha do tempo. No consumo, o analista busca, verifica e confirma cada achado antes que ele entre em relatório.
Uma decisão atravessa todas as camadas: nenhum modelo processa o conteúdo fora do país (RNF07). No Azure Databricks em São Paulo, as Foundation Model APIs e funções prontas como ai_classify e ai_parse_document só funcionam com o processamento entre geografias habilitado. Por isso, todos os modelos desta arquitetura que leem o conteúdo das mensagens, de transcrição, OCR, embeddings e linguagem, são modelos abertos servidos em endpoints próprios de Model Serving com GPU, disponíveis na região.
Camada bronze: ingestão com rastreabilidade
O ponto de partida é a extração de dados já feita do aparelho. O Auto Loader copia os arquivos para um Volume do Unity Catalog e calcula o SHA-256 de cada um (uma impressão digital do arquivo, que prova que ele não foi alterado). A tabela bronze nunca é apagada nem compactada, e o histórico do Delta passa a fazer parte do rastreio da informação.
Camada prata: estruturação
Os processos rodam em paralelo:
- Áudios passam pelo Whisper large-v3 num endpoint de Model Serving com GPU. Nas mensagens de voz, quem fala já vem nos metadados (o remetente). A diarização, que separa vozes diferentes dentro de um mesmo áudio, entra nas gravações com mais de uma pessoa; ela distingue as vozes, mas não diz quem é cada uma.
- Chats e registros de chamadas viram tabelas normalizadas de mensagens, chamadas e contatos, com fuso horário explícito. Como as mensagens ficam todas dentro de um único banco de dados do aplicativo, o hash do arquivo não basta: cada mensagem recebe seu próprio hash, calculado sobre o conteúdo e os metadados, e guarda o hash do arquivo de origem. Assim, qualquer citação pode ser conferida até o arquivo extraído.
- Conteúdo íntimo é marcado por um classificador, o mesmo LLM próprio chamado via ai_query, e essas marcas viram tags governadas que escondem o conteúdo por padrão.
- Imagens e documentos passam por um modelo aberto de OCR servido em GPU, e o texto extraído entra no mesmo fluxo das mensagens.
Camada ouro: enriquecimento e correlação
Com ai_query sobre o modelo aberto servido no endpoint próprio, cada janela de conversa gera registros estruturados: pessoas citadas, eventos, valores e datas, sempre com o trecho literal e o hash da mensagem de origem. Os textos também viram embeddings (representações numéricas do sentido do texto), gerados por um modelo multilíngue próprio e indexados no AI Search, para busca por significado e não só por palavra. A camada de correlação monta o grafo de contatos (quem fala com quem, quando e por qual canal) e uma linha do tempo que pode ser cruzada com datas de eventos públicos ligados ao objeto autorizado.
Camada de consumo: revisão humana
É aqui que a arquitetura responde à "falta de braço" (RNF04): a equipe deixa de ler tudo em sequência e passa a revisar o que foi sinalizado, em ordem de relevância. Um Databricks App oferece busca, filtros e o fluxo de verificação de relatório:
- O analista cola um parágrafo de um relatório, e o sistema recupera mensagens candidatas.
- O LLM separa essas mensagens entre "sustenta", "contradiz" e "inconclusivo", cada uma com link para a fonte.
- O analista confirma ou descarta cada uma.
Para perguntas estruturadas sobre o grafo e a linha do tempo, um espaço do AI/BI Genie aceita consultas em linguagem natural, sob as mesmas regras do Unity Catalog. Como o Genie usa modelos do Azure AI Services, e não os modelos próprios, ele fica restrito às tabelas de metadados (quem, quando, por qual canal), sem acesso ao texto das mensagens.
Só o que o analista confirma entra nos relatórios, que citam o hash de cada mensagem e o do arquivo de origem.
E se o caso for maior?
Para volumes como os 7 TB citados pela reportagem (RNF06), o desenho não muda. O Auto Loader processa os arquivos de forma incremental, os endpoints ganham réplicas, e o custo cresce com o conteúdo a processar (horas de áudio, mensagens e páginas), não com os bytes.
Governança e segurança
Governança no Unity Catalog
Cada processo ganha um catálogo próprio e cada gabinete, um grupo com tabelas de trabalho isoladas (RNF01, RNF03). Filtros de linha limitam cada consulta ao recorte autorizado (RF04), e máscaras baseadas em tags escondem o conteúdo marcado como íntimo até que alguém com permissão o libere, com justificativa registrada (RNF02).
Modelos dentro do perímetro e dentro do país
No Azure Databricks em São Paulo, as Foundation Model APIs (pay-per-token e provisioned throughput) e funções prontas como ai_classify, ai_extract e ai_parse_document só funcionam com o processamento entre geografias habilitado: os dados continuam armazenados no Brasil, mas são processados em outra região. Para material sob sigilo, isso não serve.
A alternativa é servir modelos abertos em endpoints próprios de Model Serving com GPU, disponíveis na região, e chamá-los via ai_query. Os endpoints ficam sob o Unity Gateway, que controla quem pode chamá-los, impõe limites de uso e registra cada chamada. Endpoints para provedores externos ficam bloqueados.
O log também é dado sensível
As tabelas de inferência guardam prompts e respostas, ou seja, trechos das conversas. Elas precisam viver no mesmo catálogo governado, com as mesmas regras de acesso e retenção.
Rede e criptografia
Private Link, sem saída para a internet pública, controle de egress do serverless (a saída de dados da rede), chaves gerenciadas pelo cliente e o compliance security profile. Este último exige o add-on Enhanced Security and Compliance, que tem custo próprio e entra na conta a seguir.
Quanto custa executar a análise
Processar o caso custa cerca de US$ 475 por rodada completa e US$ 675 a 875 no total do processamento, com todos os modelos rodando no Brasil. Manter a plataforma no ar para a revisão custa cerca de US$ 5 mil por mês (R$ 27,5 mil).
Premissas
- Preços: lista do Azure Databricks na região Brazil South, plano Premium, consultados em 11/10/2026 na API pública de preços da Microsoft: US$ 0,112 por DBU de Model Serving, US$ 0,59 por DBU de jobs serverless, US$ 1,09 por DBU de SQL serverless e de Apps, e US$ 0,10 por DBU do add-on Enhanced Security and Compliance. DBU é a unidade de consumo do Databricks.
- GPUs: uma T4 consome 10,48 DBU/h e uma A100 de 80 GB, 78,6 DBU/h, o equivalente a 1/8 dos 628 DBU/h da configuração com oito A100.
- Velocidades supostas: Whisper a cerca de 6 vezes o tempo real numa T4, já com diarização; LLM a cerca de 2 mil tokens por segundo numa A100, com processamento em lote.
- Volume de texto: 500 mil mensagens de ~25 tokens e 500 h de áudio a ~11 mil tokens por hora formam um corpus de ~18 milhões de tokens. A extração lê esse corpus com 2,5 vezes de sobrecarga (instruções e sobreposição de janelas), e a classificação de intimidade faz outra passada: ~75 milhões de tokens de entrada e ~8 milhões de saída.
- OCR: hipótese de ~20 mil páginas e imagens.
- Endpoints desligados ao fim de cada lote. Câmbio de US$ 1 = R$ 5,50.
Uma rodada completa
| Etapa | Recurso | Consumo | DBU | Custo (US$) |
|---|---|---|---|---|
| Transcrição e diarização de 500 h | Whisper large-v3, GPU T4 | ~85 h de GPU | ~890 | ~100 |
| Classificação de intimidade e extração | Modelo aberto (ex.: gpt-oss-120b), GPU A100 80 GB | ~12 h de GPU para ~83 milhões de tokens | ~945 | ~105 |
| OCR de imagens e documentos | Modelo aberto de OCR, GPU T4 | ~5 h de GPU | ~50 | ~6 |
| Embeddings | Modelo aberto multilíngue, GPU T4 | ~3 h de GPU para ~25 milhões de tokens | ~30 | ~4 |
| Ingestão e normalização | Jobs serverless | Sem GPU | ~100 | ~60 |
| Subtotal de computação | ~2.020 | ~275 | ||
| Add-on Enhanced Security and Compliance | US$ 0,10 por DBU | ~200 | ||
| Rodada completa | ~475 |
Na prática, transcrição, OCR e ingestão rodam uma vez. O que se repete é a extração com LLM, por ajustes de prompt, a cerca de US$ 200 por passada já com o add-on. Com uma ou duas passadas extras, o processamento fica em US$ 675 a 875, ou R$ 3,7 mil a R$ 4,8 mil.
Somadas, as etapas com GPU da Tabela 2 usam cerca de 105 horas de máquina, ou 4 a 5 dias corridos com um endpoint por etapa, e menos com réplicas.
O que sobra para as pessoas
O processamento não elimina a leitura humana; muda o que se lê. Se a triagem reduzir a revisão a 10% a 20% do material, uma hipótese que depende do escopo autorizado, seriam 175 a 350 horas, calculadas sobre as 1.750 horas do cenário base: de 2 semanas a 1 mês da mesma equipe, contra cerca de 5 meses lendo tudo.
Operação mensal
| Item | Dimensionamento | US$ por mês |
|---|---|---|
| Endpoint do LLM para a revisão | 1 A100, ~8 h por dia útil | ~1.550 |
| SQL warehouse serverless X-Small | ~120 h por mês | ~785 |
| Databricks App | Medium, ligado 24 h | ~400 |
| AI Search | 1 unidade Standard, 24 h | ~325 |
| Armazenamento e rede privada | ~1,5 TB, Private Endpoints | ~150 |
| Add-on Enhanced Security and Compliance | US$ 0,10 por DBU | ~1.785 |
| Total | ~5.000 |
Servir os modelos em GPU própria tem preço: paga-se pela hora de máquina ligada, não por token. A conta mensal fica em cerca de US$ 5 mil (R$ 27,5 mil), e o endpoint de consulta mais o add-on de segurança respondem por dois terços dela. Desligar o endpoint fora do expediente e dimensionar a GPU ao uso real são essenciais para deixar a solução viável.
Limites e cuidados: o que a IA não faz
A arquitetura resolve o problema de volume, mas não resolve sozinha o que torna esse caso delicado. Alguns limites estão fora do alcance de qualquer plataforma; outros dependem de como ela é configurada.
Limites técnicos
- O LLM pode errar com confiança. Por isso a camada ouro exige o trecho literal e o hash da mensagem em cada registro. Um passo automático confere se o trecho existe na fonte, e o que não confere é descartado. Ainda assim, a extração é triagem, não conclusão.
- Áudio de celular é difícil. Ruído, gírias e falas sobrepostas elevam o erro de transcrição, e ele costuma cair justamente nos nomes próprios, que são o objeto do RF03. Trechos relevantes precisam ser ouvidos por uma pessoa antes de entrar em relatório.
- Quem é quem. Apelidos, tratamentos como "Doutor" e contatos sem nome exigem validação humana. A diarização separa vozes, mas não as identifica. Um erro aqui contamina todo o grafo de contatos.
- Modelos abertos dão mais trabalho. Servir os próprios modelos garante que o conteúdo fique no país, mas exige escolher, testar e manter cada modelo, e medir a qualidade em português antes de confiar nele.
Limites jurídicos
- Sigilo e dados no Brasil. Rodar os modelos no Brasil resolve onde o conteúdo é processado, mas os dados continuam na nuvem de um fornecedor estrangeiro. Para material sob segredo de justiça, essa é uma decisão jurídica, não técnica.
- A LGPD não resolve sozinha. Ela exclui do seu alcance o tratamento de dados feito para fins exclusivos de investigação e repressão de infrações penais (art. 4º, III, d). Valem o sigilo processual e a proteção constitucional à intimidade.
- Finalidade. Uma ferramenta que encontra tudo facilita buscas além do que foi autorizado. O escopo do RF04 precisa estar no controle de acesso, nos filtros do Unity Catalog e nas políticas do Unity Gateway, e cada pergunta feita ao sistema deve ficar registrada.
- Regras para IA no Judiciário. A Resolução CNJ 615/2025 exige supervisão humana proporcional ao risco e mantém a interpretação de provas como atividade humana. Em nossa leitura, se a correlação for usada para avaliar pessoas, o sistema tende a ser classificado como de alto risco.
Limites éticos
- Correlação não é causalidade. Cruzar a linha do tempo com datas públicas é a parte mais tentadora e a mais perigosa. Um pico de mensagens perto de um evento pode ter muitas explicações, e o grafo mostra frequência, não a natureza de uma relação.
- Terceiros expostos. Em aparelhos assim, muitas pessoas só conversaram com o dono. O filtro de intimidade precisa protegê-las também.
- Viés de automação. Em equipes pequenas e sobrecarregadas, o problema que motivou este exercício, o risco de confiar no resumo é maior. Por isso a revisão humana fica no fim do fluxo, e todo achado leva à fonte.
Custo de implantação
- Execução barata não é projeto barato. Processar o caso custa centenas de dólares, mas construir, testar e validar essa governança leva meses de uma equipe especializada, prazo que este exercício não estima e que depende do escopo. E manter a plataforma no ar tem custo próprio, como mostra a Tabela 3.
Conclusão
Os 510 GB do caso relatado pelo jornal O Globo não são um problema de big data, necessariamente. São um problema de capacidade: poucas pessoas, muito material sensível e a exigência de que cada conclusão aponte para a mensagem original.
Com ingestão governada, transcrição, modelos abertos rodando no Brasil e busca semântica, uma leitura que levaria de 3 a 9 meses vira dias de processamento e algumas semanas de revisão do que foi sinalizado, com custo de processamento na casa das centenas de dólares e cerca de US$ 5 mil por mês para manter a plataforma durante a revisão. O que a tecnologia não faz é decidir o que pode ser buscado, nem substituir quem lê. Esses limites são parte do projeto, não um detalhe dele.
Talvez a lição mais útil seja esta: com dados sensíveis, a melhor arquitetura não é a que encontra tudo, e sim a que encontra só o que foi autorizado, sem tirar o conteúdo do país, e mostra de onde veio cada resposta.
A Planncode é parceira da Databricks e da Microsoft e projeta plataformas de dados como esta. Se a sua organização precisa analisar um grande volume de conversas, documentos ou áudios sem tirar o conteúdo do país, fale com a gente.
Perguntas frequentes
Quanto tempo uma equipe pequena levaria para analisar 510 GB de conversas?
Com 4 pessoas em tempo parcial, de 3 a 9 meses para ler as mensagens e ouvir os áudios, conforme o rigor da leitura. Nas premissas deste exercício, cerca de 5 meses.
Quanto custa processar esse volume com IA no Databricks?
Cerca de US$ 475 por rodada completa, a preços de lista do Azure Databricks em São Paulo, com os modelos rodando no Brasil e o add-on de segurança incluído. Contando as passadas extras de extração, entre US$ 675 e 875 (R$ 3,7 mil a R$ 4,8 mil). Manter a plataforma no ar durante a revisão custa cerca de US$ 5 mil por mês (R$ 27,5 mil).
Quanto tempo de revisão humana sobra?
Depende do escopo autorizado. Se a triagem reduzir a leitura a 10% a 20% do material, seriam 175 a 350 horas: de 2 semanas a 1 mês para a mesma equipe de 4 pessoas em tempo parcial.
Os dados saem do Brasil?
O conteúdo das mensagens é processado no Brasil: todos os modelos que o leem são abertos e servidos em GPU dentro da região, porque os modelos prontos do Databricks em São Paulo só funcionam com processamento em outra região. Os dados ficam na nuvem de um fornecedor estrangeiro, o que é uma decisão jurídica (veja a última pergunta).
Como a arquitetura garante que cada achado seja verificável?
Cada mensagem tem seu próprio hash, ligado ao hash do arquivo de origem. Cada registro da camada ouro traz o trecho literal e esse hash, e os relatórios citam os dois.
A IA substitui os analistas?
Não. A extração é triagem, não conclusão: só o que o analista confirma entra nos relatórios.
Dá para usar essa arquitetura com material sob sigilo?
Depende de uma decisão jurídica, não técnica. Mesmo com os modelos rodando no Brasil, Private Link e chaves próprias, os dados ficam na nuvem de um fornecedor estrangeiro, e a Resolução CNJ 615/2025 exige supervisão humana e classificação de risco.
Fontes e referências
- Gabinetes do STF dedicam equipes para analisar celular de Vorcaro, mas veem volume de conversas como desafio. O Globo, 23/09/2026
- Mattos Filho: o futuro do uso de IA pelo Judiciário
- JusDocs: o que muda com a Resolução CNJ 615/2025
- Revista Algoritmos e Sociedade (UFMG): Resolução n. 615/2025
- TRT4: ata do Subcomitê de Governança de IA, maio de 2026
- Microsoft: recursos do Azure Databricks com disponibilidade regional limitada
- Microsoft: Databricks Designated Services e processamento entre geografias
- Microsoft: endpoints de Model Serving para modelos próprios e tipos de GPU
- Databricks: preços de Model Serving com GPU
- Databricks: documentação do Unity Gateway
- Lei 13.709/2018 (LGPD), texto compilado no Planalto
- Microsoft: Azure Retail Prices API, Azure Databricks na região Brazil South (consulta em 11/10/2026)